MITIGASI PENGANGGURAN FRIKSIONAL MELALUI SKEMA PENCOCOKAN KERJA BERBASIS KECERDASAN BUATAN: PELUANG, RISIKO BIAS ALGORITMIK, DAN BATAS KEWENANGAN DINAS TENAGA KERJA
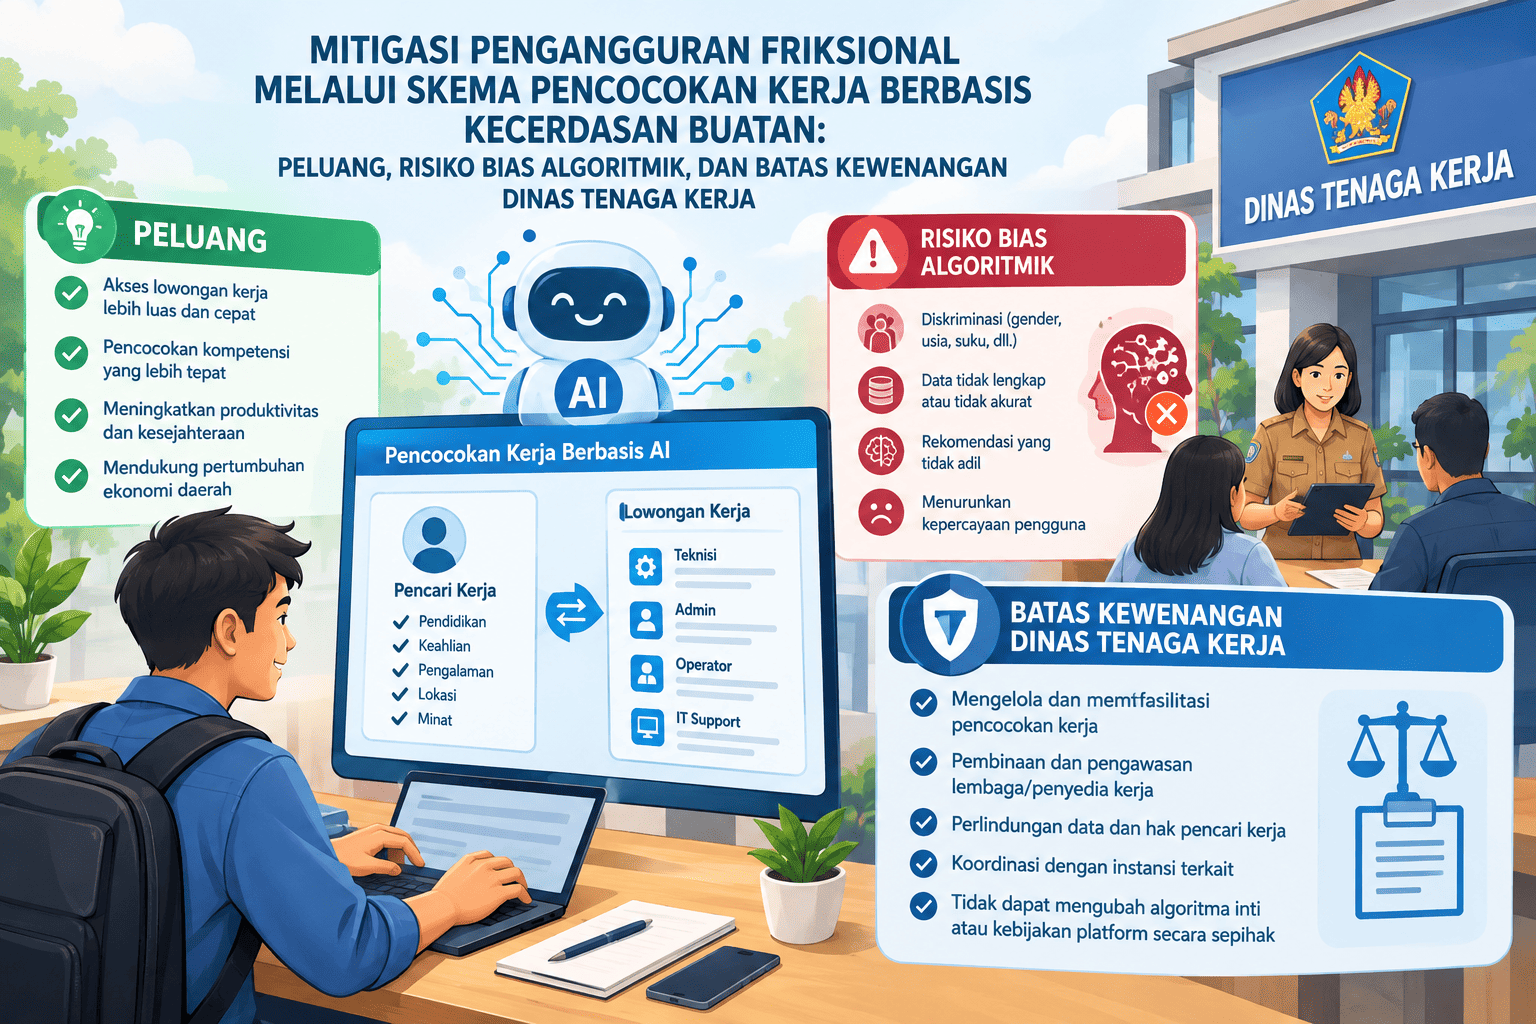
MITIGASI
PENGANGGURAN FRIKSIONAL MELALUI SKEMA PENCOCOKAN KERJA BERBASIS KECERDASAN
BUATAN: PELUANG, RISIKO BIAS ALGORITMIK, DAN BATAS KEWENANGAN DINAS TENAGA
KERJA
ABSTRAK
Pengangguran friksional yang berkepanjangan sering
disebabkan oleh lemahnya mekanisme pencocokan antara profil pencari kerja
dengan kualifikasi yang dibutuhkan pemberi kerja. Kemajuan kecerdasan buatan
membuka peluang bagi layanan penempatan tenaga kerja publik untuk melakukan
pencocokan secara otomatis dan berskala besar. Namun, penerapan teknologi ini
pada layanan publik menimbulkan persoalan baru berupa risiko bias algoritmik,
keterbatasan akuntabilitas, dan potensi pelanggaran perlindungan data pribadi.
Penelitian ini bertujuan menganalisis peluang penerapan skema pencocokan kerja
berbasis kecerdasan buatan pada bursa kerja daerah, mengidentifikasi risiko
yang menyertainya, serta merumuskan batas kewenangan yang perlu dijaga oleh
Dinas Tenaga Kerja, Transmigrasi dan Energi Sumber Daya Mineral. Penelitian
menggunakan pendekatan kualitatif dengan desain eksploratif, memadukan
wawancara mendalam terhadap aparatur, pencari kerja, dan pengelola platform,
dengan telaah literatur sistematis terhadap praktik layanan ketenagakerjaan
publik berbasis algoritma di berbagai negara. Hasil penelitian menunjukkan
bahwa manfaat terbesar kecerdasan buatan bukan pada pengambilan keputusan
penempatan, melainkan pada pekerjaan pendukung seperti penstandaran jabatan,
pembersihan data, dan penyusunan rekomendasi pelatihan. Risiko terbesar muncul
ketika algoritma dilatih dengan data historis penempatan yang telah mengandung
bias gender dan bias usia, sehingga sistem mereproduksi ketimpangan yang
seharusnya dikoreksi. Penelitian merekomendasikan penerapan prinsip manusia
dalam lingkar pengambilan keputusan, audit algoritma secara berkala,
transparansi kriteria pencocokan, serta pembatasan tegas agar keputusan yang
berdampak hukum tetap berada di tangan pejabat.
Kata kunci: pencocokan kerja, kecerdasan buatan, bias
algoritmik, pengangguran friksional, akuntabilitas publik
ABSTRACT
Prolonged frictional unemployment often stems from
weak matching mechanisms between jobseeker profiles and employer requirements.
Advances in artificial intelligence offer public employment services the
opportunity to perform automated large-scale matching. However, applying such
technology to public services raises concerns over algorithmic bias, limited
accountability, and personal data protection. This study analyses opportunities
for AI-based job matching in regional employment exchanges, identifies
attendant risks, and formulates the authority boundaries that the Regional
Office of Manpower, Transmigration and Mineral Energy Resources must maintain.
A qualitative exploratory design combines in-depth interviews with officials,
jobseekers and platform managers with a systematic review of algorithm-based
public employment practices across countries. Findings show the greatest
benefit lies not in placement decision-making but in supporting tasks such as
occupational standardisation, data cleaning, and training recommendations. The
greatest risk arises when algorithms are trained on historical placement data
already containing gender and age bias, reproducing inequalities that should be
corrected. The study recommends human-in-the-loop principles, periodic
algorithmic audits, transparency of matching criteria, and strict limits
keeping legally consequential decisions with officials.
Keywords: job matching, artificial intelligence,
algorithmic bias, frictional unemployment, public accountability
PENDAHULUAN
Data ketenagakerjaan di banyak daerah menunjukkan situasi yang tampak
paradoks. Pada satu sisi terdapat jumlah pencari kerja terdaftar yang besar,
sementara pada sisi lain sejumlah perusahaan mengeluhkan sulitnya memperoleh
tenaga kerja dengan kualifikasi tertentu. Keadaan ini mengindikasikan bahwa
persoalan tidak selalu terletak pada kekurangan lowongan atau kelebihan tenaga
kerja, melainkan pada kegagalan proses pencocokan. Dalam literatur ekonomi
ketenagakerjaan, kondisi ini dikategorikan sebagai pengangguran friksional yang
timbul karena informasi tidak sempurna dan biaya pencarian yang tinggi.
Layanan penempatan tenaga kerja yang diselenggarakan pemerintah daerah
secara tradisional mengandalkan pengantar kerja untuk melakukan pencocokan
secara manual. Metode ini memiliki keunggulan berupa penilaian kontekstual yang
mempertimbangkan karakter, kesiapan psikologis, dan kondisi sosial pencari
kerja. Kelemahannya terletak pada keterbatasan skala. Seorang pengantar kerja
yang harus melayani ribuan pencari kerja tidak mungkin melakukan pencocokan
mendalam untuk setiap individu, sehingga proses cenderung disederhanakan
menjadi pencocokan berdasarkan pendidikan terakhir.
Perkembangan kecerdasan buatan, khususnya teknik pemrosesan bahasa alami
dan sistem rekomendasi, menawarkan kemungkinan baru. Sistem dapat membaca
uraian pekerjaan dan riwayat hidup dalam bentuk teks bebas, mengekstraksi
keterampilan yang tersirat, dan menghitung tingkat kesesuaian antara pencari
kerja dengan lowongan. Beberapa negara telah menerapkan pendekatan semacam ini
pada layanan ketenagakerjaan publik dan melaporkan peningkatan efisiensi.
Ketertarikan pemerintah daerah di Indonesia terhadap teknologi ini pun
meningkat, terlihat dari munculnya wacana pengembangan bursa kerja cerdas dalam
berbagai dokumen inovasi daerah.
Meskipun demikian, penerapan kecerdasan buatan pada layanan publik
ketenagakerjaan tidak dapat disamakan dengan penerapannya pada platform
komersial. Layanan publik terikat pada prinsip kesetaraan, nondiskriminasi, dan
akuntabilitas. Ketika sebuah algoritma menentukan siapa yang direkomendasikan
pada suatu lowongan, keputusan tersebut memiliki konsekuensi distributif.
Apabila algoritma dilatih menggunakan data penempatan masa lalu yang telah
mengandung pola diskriminatif, misalnya kecenderungan menempatkan perempuan
pada jabatan administratif atau menyingkirkan pelamar berusia lanjut, maka
sistem akan mempelajari dan mengulangi pola tersebut dengan efisiensi yang
lebih tinggi.
Persoalan berikutnya adalah akuntabilitas. Dalam administrasi publik,
setiap keputusan harus dapat dijelaskan alasannya kepada warga. Sebagian model
kecerdasan buatan bekerja dengan cara yang sulit ditelusuri, sehingga pejabat
kesulitan menjelaskan mengapa seorang pencari kerja tidak direkomendasikan.
Ketidakmampuan menjelaskan ini berpotensi menimbulkan sengketa dan menggerus
kepercayaan publik. Selain itu, pemrosesan data pribadi pencari kerja menuntut
kepatuhan terhadap ketentuan perlindungan data pribadi yang kini memiliki dasar
hukum yang lebih tegas.
Berdasarkan uraian tersebut, penelitian ini dirumuskan untuk menjawab
tiga pertanyaan. Pertama, pada fungsi apa saja kecerdasan buatan dapat
memberikan manfaat nyata bagi layanan penempatan tenaga kerja daerah. Kedua,
risiko apa yang muncul dan bagaimana mekanismenya. Ketiga, batas kewenangan
seperti apa yang perlu ditetapkan agar penggunaan teknologi tetap sejalan
dengan prinsip pelayanan publik.
TINJAUAN PUSTAKA
Teori Pencarian dan Pencocokan Kerja
Teori pencarian dan pencocokan menjelaskan bahwa pertemuan antara pencari
kerja dan lowongan merupakan proses yang memakan waktu dan biaya. Fungsi
pencocokan menggambarkan hubungan antara jumlah pencari kerja, jumlah lowongan,
dan jumlah penempatan yang terjadi. Efisiensi pencocokan dapat ditingkatkan
dengan memperbaiki kualitas informasi. Dari perspektif ini, intervensi
teknologi dibenarkan sepanjang benar-benar menurunkan biaya pencarian dan bukan
sekadar memindahkan proses manual ke layar.
Kecerdasan Buatan dalam Layanan Publik
Literatur mengenai kecerdasan buatan di sektor publik membedakan tiga
tingkat penggunaan. Tingkat pertama adalah otomatisasi tugas administratif yang
berulang dan berisiko rendah. Tingkat kedua adalah dukungan pengambilan
keputusan, ketika sistem memberikan rekomendasi yang tetap diputuskan manusia.
Tingkat ketiga adalah pengambilan keputusan otomatis tanpa campur tangan
manusia. Semakin tinggi tingkatnya, semakin besar tuntutan akuntabilitas dan
semakin ketat pengendalian yang diperlukan.
Bias Algoritmik dan Keadilan
Bias algoritmik dapat bersumber dari data pelatihan yang tidak
representatif, dari pemilihan variabel yang berkorelasi dengan atribut yang
dilindungi, serta dari umpan balik sistem yang memperkuat pola awal. Pada
layanan ketenagakerjaan, variabel seperti alamat tempat tinggal, jenis sekolah,
atau riwayat pekerjaan sebelumnya dapat menjadi proksi bagi status sosial
ekonomi dan menghasilkan diskriminasi tidak langsung. Karena itu, penilaian
keadilan tidak cukup dilakukan dengan menghapus variabel identitas, melainkan
memerlukan pengujian dampak terhadap kelompok.
METODOLOGI PENELITIAN
Penelitian ini menggunakan pendekatan kualitatif dengan desain
eksploratif. Desain eksploratif dipilih karena penerapan kecerdasan buatan pada
layanan ketenagakerjaan daerah masih berada pada tahap awal, sehingga
penelitian bertujuan memetakan kemungkinan, risiko, dan batasan, bukan menguji
efektivitas sistem yang telah berjalan penuh.
Sumber data terdiri atas data primer dan data sekunder. Data primer
diperoleh melalui wawancara mendalam terhadap kepala bidang penempatan tenaga
kerja, pengantar kerja, pengelola sistem informasi dinas, pengembang platform
yang pernah bekerja sama dengan pemerintah daerah, serta pencari kerja yang
pernah menggunakan layanan bursa kerja daring. Data sekunder diperoleh melalui
telaah literatur sistematis terhadap artikel ilmiah, laporan organisasi
internasional, dan dokumen kebijakan mengenai penggunaan algoritma pada layanan
ketenagakerjaan publik.
Telaah literatur dilakukan dengan menetapkan kriteria inklusi berupa
publikasi dalam rentang sepuluh tahun terakhir, membahas layanan
ketenagakerjaan publik, dan memuat pembahasan mengenai mekanisme pencocokan
atau dampaknya terhadap keadilan. Kriteria eksklusi meliputi publikasi yang
hanya membahas rekrutmen di sektor swasta tanpa dimensi kebijakan publik.
Artikel yang memenuhi kriteria kemudian dianalisis secara tematik untuk
mengidentifikasi pola manfaat dan risiko yang berulang.
Analisis data dilakukan melalui analisis tematik dengan tahapan pengenalan
data, penyusunan kode awal, pencarian tema, peninjauan tema, penamaan tema, dan
penulisan laporan. Hasil analisis tematik dari literatur kemudian
dikonfrontasikan dengan temuan wawancara untuk menilai relevansinya dengan
konteks kelembagaan daerah. Untuk merumuskan batas kewenangan, peneliti
menggunakan kerangka tiga tingkat penggunaan kecerdasan buatan di sektor publik
sebagai alat klasifikasi.
Keabsahan data dijaga melalui triangulasi sumber, pengecekan anggota
terhadap informan kunci, serta penyediaan jejak audit berupa catatan lapangan
dan dokumentasi proses pengodean. Penelitian ini memperhatikan etika penelitian
dengan menjaga kerahasiaan identitas informan dan tidak mengakses data pribadi
pencari kerja secara langsung.
HASIL DAN PEMBAHASAN
Fungsi yang Paling Layak Diotomatisasi
Temuan penelitian menunjukkan bahwa manfaat paling nyata dari kecerdasan
buatan bagi layanan ketenagakerjaan daerah justru berada pada pekerjaan
pendukung yang selama ini menyita waktu aparatur, bukan pada pengambilan keputusan
penempatan. Tiga fungsi menonjol dalam temuan ini. Pertama, penstandaran nama
jabatan. Perusahaan menuliskan nama jabatan dengan beragam istilah untuk
pekerjaan yang secara substantif sama, sehingga data lowongan sulit diagregasi.
Sistem yang mampu memetakan variasi penulisan ke dalam klasifikasi jabatan baku
dapat meningkatkan mutu statistik ketenagakerjaan daerah secara signifikan.
Kedua, pembersihan dan pelengkapan data. Banyak isian riwayat hidup
pencari kerja tidak lengkap atau tidak konsisten. Sistem dapat mendeteksi
anomali, mengingatkan pengguna untuk melengkapi isian, serta mengekstraksi
keterampilan dari uraian pengalaman kerja yang ditulis dalam kalimat bebas.
Ketiga, penyusunan rekomendasi pelatihan. Dengan membandingkan keterampilan yang
dimiliki pencari kerja terhadap keterampilan yang paling sering diminta pasar,
sistem dapat menyarankan pelatihan yang relevan. Fungsi ini bersifat
memberdayakan karena tidak menutup peluang, melainkan menambah informasi bagi
pencari kerja.
Ketiga fungsi tersebut memiliki kesamaan, yaitu berisiko rendah karena
tidak menghasilkan keputusan yang menutup akses seseorang terhadap pekerjaan.
Kesalahan pada fungsi ini dapat dikoreksi tanpa menimbulkan kerugian hukum.
Temuan ini menunjukkan bahwa strategi adopsi teknologi yang paling bijaksana
adalah memulai dari lapisan pendukung, bukan dari lapisan keputusan.
Mekanisme Munculnya Bias
Penelitian mengidentifikasi tiga jalur munculnya bias dalam skema
pencocokan otomatis. Jalur pertama adalah bias data historis. Apabila sistem
dilatih menggunakan catatan penempatan masa lalu, sistem akan mempelajari pola
siapa yang dahulu diterima pada jabatan tertentu. Jika pola tersebut mengandung
kecenderungan diskriminatif, sistem akan menyimpulkan bahwa pola itu merupakan
penanda kesesuaian.
Jalur kedua adalah bias variabel proksi. Penghapusan variabel jenis
kelamin dan usia tidak menghilangkan diskriminasi apabila sistem masih
menggunakan variabel yang berkorelasi kuat dengan atribut tersebut, misalnya
tahun kelulusan yang praktis mengungkapkan usia, atau riwayat cuti panjang yang
sering berkaitan dengan cuti melahirkan. Jalur ketiga adalah bias umpan balik.
Ketika sistem merekomendasikan kandidat tertentu dan perusahaan menerimanya,
data penerimaan tersebut kembali menjadi bahan pelatihan yang memperkuat
kecenderungan awal. Lingkaran ini membuat ketimpangan semakin dalam seiring
waktu.
Implikasi dari temuan ini adalah bahwa pengujian keadilan tidak dapat
dilakukan sekali pada saat pengadaan. Audit perlu dilakukan secara berkala
dengan memeriksa distribusi rekomendasi menurut kelompok jenis kelamin,
kelompok usia, dan wilayah asal, kemudian membandingkannya dengan komposisi
pencari kerja terdaftar. Selisih yang signifikan menjadi sinyal awal adanya
bias yang perlu ditelusuri.
Akuntabilitas dan Batas Kewenangan
Wawancara dengan aparatur mengungkap kekhawatiran yang konsisten mengenai
pertanggungjawaban. Pejabat menyadari bahwa mereka tetap menjadi pihak yang
dimintai penjelasan ketika terjadi keberatan dari pencari kerja, terlepas dari
apakah keputusan dihasilkan oleh sistem atau manusia. Kekhawatiran ini
beralasan secara hukum, karena tanggung jawab administrasi melekat pada
jabatan, bukan pada perangkat lunak.
Berdasarkan pertimbangan tersebut, penelitian merumuskan batas kewenangan
dalam tiga lapis. Lapis pertama, keputusan yang menimbulkan akibat hukum,
seperti penerbitan rekomendasi resmi, penetapan peserta pelatihan bersubsidi,
atau penentuan prioritas penempatan, harus tetap diputuskan oleh pejabat
berwenang. Lapis kedua, sistem hanya boleh berfungsi menyusun daftar kandidat
yang relevan tanpa memberi peringkat tunggal yang bersifat menutup, sehingga
pengantar kerja tetap memiliki ruang penilaian. Lapis ketiga, kriteria
pencocokan harus dapat dijelaskan kepada pengguna dalam bahasa sederhana dan
tersedia mekanisme keberatan bagi pencari kerja yang merasa dirugikan.
Perlindungan Data Pribadi
Pemrosesan data pribadi pencari kerja menuntut dasar pemrosesan yang
jelas, pembatasan tujuan, dan minimalisasi data. Temuan penelitian menunjukkan
bahwa formulir pendaftaran pencari kerja sering meminta informasi yang tidak
diperlukan untuk pencocokan, misalnya status perkawinan dan jumlah tanggungan.
Informasi semacam ini tidak hanya berlebihan, tetapi juga meningkatkan risiko
diskriminasi apabila dimasukkan ke dalam model. Karena itu, penyederhanaan
formulir merupakan langkah perlindungan sekaligus langkah peningkatan mutu
model.
Sintesis
Secara keseluruhan, penelitian ini menyimpulkan bahwa pertanyaan yang
tepat bukan apakah kecerdasan buatan sebaiknya digunakan, melainkan pada fungsi
apa dan dengan pengamanan apa. Penerapan yang dimulai dari fungsi pendukung
berisiko rendah memberi kesempatan bagi organisasi membangun kapasitas,
memperbaiki mutu data, dan menyusun tata kelola sebelum memasuki wilayah
keputusan yang sensitif. Pendekatan bertahap semacam ini lebih realistis
dibandingkan ambisi membangun sistem pencocokan otomatis penuh yang belum
didukung kesiapan data maupun kelembagaan.
PENUTUP
Kesimpulan
Pertama, manfaat paling layak dan berisiko rendah dari penerapan
kecerdasan buatan pada layanan ketenagakerjaan daerah terletak pada fungsi
pendukung, yaitu penstandaran nama jabatan, pembersihan dan pelengkapan data,
serta penyusunan rekomendasi pelatihan.
Kedua, risiko bias muncul melalui tiga jalur, yaitu bias data historis,
bias variabel proksi, dan bias umpan balik, yang secara bersama-sama berpotensi
mereproduksi ketimpangan gender, usia, dan wilayah asal dengan skala yang lebih
besar dibandingkan proses manual.
Ketiga, batas kewenangan perlu ditetapkan dalam tiga lapis, yaitu
keputusan berakibat hukum tetap berada pada pejabat, sistem hanya menyusun
daftar kandidat tanpa peringkat yang menutup, dan kriteria pencocokan wajib
dapat dijelaskan disertai mekanisme keberatan.
Keempat, pengumpulan data pribadi yang berlebihan pada formulir
pendaftaran meningkatkan risiko diskriminasi sekaligus menurunkan mutu model,
sehingga penyederhanaan formulir merupakan langkah yang menguntungkan dari dua
sisi.
Saran
Pertama, dinas disarankan menerapkan pendekatan bertahap dengan memulai
otomatisasi pada fungsi pendukung sebelum mempertimbangkan fungsi pencocokan
tingkat lanjut.
Kedua, perlu disusun pedoman internal penggunaan kecerdasan buatan yang
memuat prinsip manusia dalam lingkar pengambilan keputusan, kewajiban
penjelasan, dan larangan penggunaan variabel sensitif beserta proksinya.
Ketiga, audit algoritma perlu dilakukan secara berkala dengan memeriksa
distribusi rekomendasi menurut kelompok dan mempublikasikan ringkasan hasilnya
sebagai bentuk akuntabilitas.
Keempat, formulir pendaftaran pencari kerja perlu ditinjau ulang agar
hanya memuat data yang benar-benar relevan dengan pencocokan.
Kelima, kapasitas aparatur perlu ditingkatkan tidak hanya pada aspek
teknis, tetapi juga pada pemahaman etika data dan perlindungan data pribadi.
Keenam, penelitian lanjutan disarankan melakukan uji coba terkendali
untuk mengukur dampak sistem rekomendasi terhadap durasi pencarian kerja dan
distribusi penempatan antarkelompok.